Unified Namespace : comment rendre vos données machine centralisées, cohérentes et évolutives
Le projet pilote fonctionne : une usine, une poignée de machines, les données circulent. Puis vient le moment de déployer la solution sur l’ensemble du réseau d’usines – sur 500 machines ou plus, de fabricants, d’âges et de commandes numériques différents. C’est à ce stade que de nombreux projets de digitalisation s’enlisent. La technologie existe. Le problème, c’est que chaque machine fournit ses données différemment et que chaque nouvelle application exige sa propre interface.
C’est là qu’intervient le Unified Namespace (UNS). Cet article explique le concept d’architecture qui se cache derrière, son fonctionnement et les briques nécessaires pour qu’il fonctionne au quotidien sur le shopfloor.
Quels problèmes un Unified Namespace résout-il ?
Des chiffres contradictoires → une base de données commune : lorsque le MES, l’ERP et les outils d’analyse conservent chacun leurs propres copies des données machine, les chiffres divergent. Dans un Unified Namespace, tous les systèmes accèdent à la même source. Chaque service et chaque site travaille avec les mêmes données cohérentes.
Des informations obsolètes → une vue d’ensemble en temps réel : au lieu d’attendre des exports ou des rapports de la veille, chaque système connecté voit l’état actuel de la production. L’état des machines, les quantités et les pannes sont disponibles dès qu’ils surviennent.
Une intégration complexe → une seule connexion par système : un nouveau logiciel ou une nouvelle technologie est connecté une seule fois au Unified Namespace et accède ainsi à toutes les données autorisées. Les interfaces individuelles vers chaque système existant deviennent inutiles.
Des données brutes non structurées → une base pour l’analyse prédictive et l’IA : les applications d’IA ont besoin de données structurées et contextualisées provenant de toutes les sources. Le Unified Namespace les met à disposition sous une forme uniforme.
Qu’est-ce qu’un Unified Namespace ?
En substance, un Unified Namespace (UNS) est une architecture et un modèle de conception permettant de structurer les producteurs et les consommateurs de données dans un environnement d’exploitation industriel en temps réel. En standardisant les données issues de différents systèmes, il optimise la gestion, l’échange et l’analyse des données. Cette source de données unique garantit que tous les acteurs de l’entreprise peuvent accéder plus efficacement aux informations clés, les intégrer et les analyser, ce qui accélère la prise de décision et renforce l’agilité opérationnelle. Au lieu d’établir une connexion distincte à la machine pour chaque application, le MES, l’ERP, les outils de BI ou les applications d’IA accèdent tous à la même source. L’UNS devient ainsi la source unique de vérité (single source of truth) de toute l’entreprise. Tous les services et tous les sites travaillent avec les mêmes données ; les contradictions et les doublons disparaissent. Grâce à l’architecture ouverte, il est possible d’intégrer des machines et des systèmes de différents fabricants et d’ajouter ultérieurement de nouvelles technologies sans refonte.
Comment fonctionne un Unified Namespace
Les données rejoignent l’UNS en trois étapes :
- Connecter : les machines et les systèmes sont connectés via une passerelle (gateway) ou, s’ils le prennent en charge nativement, directement via MQTT. Les technologies de transmission courantes sont OPC UA, MQTT et NATS.
- Harmoniser : les données sont converties dans une structure et un format uniformes. Ce n’est qu’ensuite que d’autres systèmes peuvent les utiliser sans effort supplémentaire.
- Distribuer : les données harmonisées sont centralisées dans un message broker, où chaque application autorisée peut s’y abonner.
La distribution repose sur le principe publish/subscribe : les sources de données envoient leurs données au broker, qui les transmet à tous les destinataires abonnés. Émetteurs et destinataires sont découplés. Si une nouvelle application a besoin de données machine, il lui suffit de s’y abonner. Aucune nouvelle interface vers la machine n’est nécessaire.
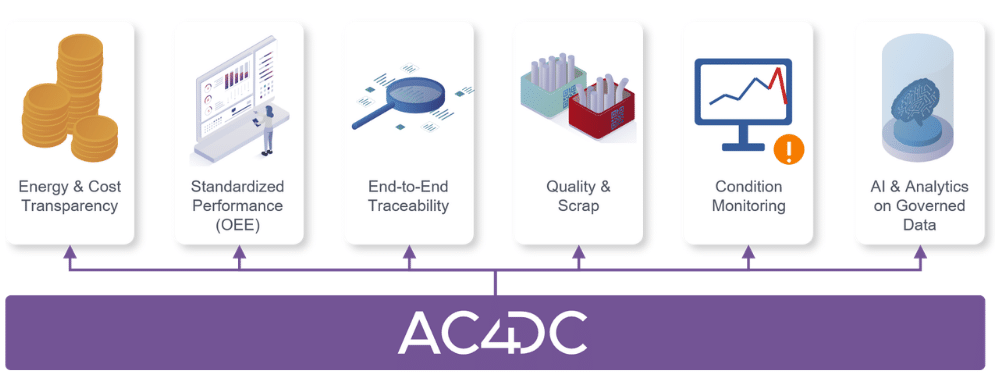
Connecter une fois, utiliser partout : différents cas d’usage s’appuient sur les mêmes données harmonisées – de l’énergie et des coûts jusqu’à l’analyse prédictive et à l’IA, en passant par l’OEE / TRS, la traçabilité, la qualité et les rebuts. Aucun d’eux ne nécessite d’interface dédiée vers la machine. Illustration avec l’exemple d’AC4DC.
Pourquoi OPC UA et MQTT ne suffisent pas à eux seuls
Une idée reçue répandue : utiliser OPC UA ou MQTT suffirait à standardiser ses données. Or ces protocoles uniformisent uniquement le transport des données, pas leur signification. Une valeur de température arrive correctement, mais le protocole ne précise pas si elle est exprimée en degrés Celsius ou Fahrenheit, à quelle machine elle appartient ni dans le cadre de quel ordre de fabrication elle a été générée.
L’étape décisive dans un Unified Namespace est donc l’harmonisation, c’est-à-dire la contextualisation des données.
Contextualisation : donner du sens aux données
La contextualisation est déterminante pour la réussite. Elle consiste à :
- déduire des informations logiques à partir de signaux, par exemple l’état de la machine,
- annoter et convertir les unités physiques,
- attribuer les quantités et les informations de qualité,
- relier les données machine aux informations des ordres de fabrication.
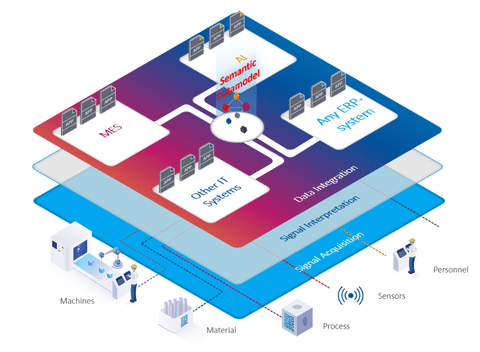
Du signal à l’information : les données issues des machines, des capteurs, des matériaux, des processus, du personnel et des ordres de fabrication sont collectées, interprétées et transmises au MES, à l’ERP, à l’IA et à d’autres systèmes informatiques via un modèle de données sémantique unifié.
Ce n’est que lorsque l’on sait précisément ce que décrit un point de données et dans quel contexte il a été généré que l’on peut en tirer des enseignements pertinents. C’est particulièrement vrai pour l’intelligence artificielle : les applications et les rapports d’IA ne fournissent des résultats exploitables que si les données sous-jacentes sont prêtes pour l’IA.
Un modèle de données unifié pour l’ensemble du parc machines
Pour éviter de devoir contextualiser chaque machine à partir de zéro, il faut un modèle de données standardisé et réutilisable pour l’ensemble du parc machines : un Unified Asset Data Model. Les structures définies une fois sont transférées sous forme de modèles (templates) à d’autres machines, lignes et sites. Cela pose les bases de processus évolutifs, du shopfloor au top floor, et facilite la collaboration entre les services et les usines.
Les systèmes de gestion modernes créent automatiquement une nouvelle version à chaque modification. Cela présente trois avantages :
- Traçabilité : on sait à tout moment quelle configuration était active et à quel moment.
- Audit et conformité : pour des exigences telles que l’ISO 9001, la FDA ou les directives de sécurité informatique, il est possible de prouver sans faille qui a effectué quelle modification, quand, et si elle a été validée.
- Réduction des risques : les modifications erronées sont rapidement identifiées et annulées, ce qui réduit les temps d’arrêt.
Architecture : comment garantir la stabilité et la sécurité du Unified Namespace
Une couche de données centrale soulève une question légitime : que se passe-t-il en cas de panne ou d’attaque ? La réponse réside dans l’architecture.
Séparer la mise à disposition et le stockage des données. La mise à disposition des données est assurée par un logiciel spécialisé, tandis que le stockage s’effectue séparément, par exemple dans des bases de données ou des data lakes. Si une couche est attaquée, les autres restent opérationnelles et la production ne s’arrête pas. Par ailleurs, les différents composants peuvent être remplacés sans compromettre l’ensemble de la solution. Cela évite tout verrouillage fournisseur (vendor lock-in).
Concevoir une IT de shopfloor économe en ressources. La production doit se poursuivre même en cas d’interruption du réseau vers les niveaux informatiques supérieurs. Les approches suivantes ont fait leurs preuves :
- Mise en mémoire tampon locale : les données sont stockées temporairement sur site afin que rien ne soit perdu en cas de problème de connexion.
- Administration centralisée : les systèmes sont administrés de manière centralisée, ce qui réduit les efforts de maintenance et les coûts de personnel.
- Consommation minimale de ressources : le matériel et les logiciels nécessitent le moins d’énergie et de puissance de calcul possible.
Héberger les grandes infrastructures de manière centrale ou régionale. Les bases de données analytiques n’ont pas leur place sur le shopfloor, mais dans des nœuds centraux ou régionaux. Les spécialistes informatiques sont ainsi regroupés au lieu d’être répartis dans chaque usine, les coûts de maintenance et d’exploitation diminuent, et de nouveaux sites ou lignes peuvent être connectés facilement. Dans les régions où le personnel informatique est rare, cela réduit en outre la dépendance au savoir-faire local.
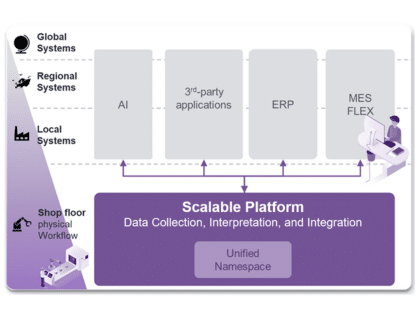
Léger sur le shopfloor, centralisé dans l’utilisation : la plateforme collecte, interprète et intègre les données au plus près de la machine et les met à disposition dans le Unified Namespace – pour des systèmes locaux, régionaux et globaux tels que le MES, l’ERP, l’IA ou des applications tierces. Les données circulent dans les deux sens.
Gestion centralisée via un Control Center
Avec des centaines de machines réparties sur plusieurs sites, un pilotage centralisé est indispensable. Un Control Center assure la gestion de toutes les machines et de tous les assets connectés. Idéalement, il repose sur Kubernetes et fonctionne en local ou dans le cloud. Ses missions comprennent :
- Gestion des licences
- Gestion des utilisateurs, y compris l’intégration de fournisseurs d’identité externes
- Gestion des certificats
- Création et gestion des gateways
- Création et gestion des modèles
- Connexion et gestion des assets
Les avantages du Unified Namespace en un coup d’œil
- Moins d’efforts d’intégration : les interfaces individuelles disparaissent, ce qui réduit les coûts de mise en œuvre et de maintenance.
- Évolutivité : les nouvelles machines, lignes et sites sont connectés à l’aide de modèles, sans modifier en profondeur les processus existants.
- Indépendance vis-à-vis des fournisseurs : les standards ouverts et la séparation des couches informatiques évitent toute dépendance envers un fournisseur unique.
- Données en temps réel : tous les systèmes accèdent à des données actualisées et peuvent réagir plus rapidement.
- Prêt pour l’IA : les données contextualisées sont la condition préalable aux applications d’IA.
- Auditabilité : les configurations versionnées répondent aux exigences de conformité.
Points à prendre en compte lors de la mise en œuvre
Un Unified Namespace ne s’installe pas, il se construit. Deux aspects sont souvent sous-estimés :
L’intégration initiale. L’UNS simplifie la distribution des données, mais les machines doivent d’abord être connectées et leurs données harmonisées. Dans les parcs machines hétérogènes du domaine OT, c’est la partie la plus exigeante.
Les limites des solutions internes. De nombreuses équipes démarrent avec des solutions low-code ou no-code et obtiennent de bons résultats sur des assets individuels. Lors du déploiement à l’échelle du réseau d’usines, il apparaît souvent que la solution maison manque de flexibilité, devient difficile à maîtriser à mesure que la complexité augmente, et se révèle peu évolutive et difficile à maintenir. La décision « make or buy » ne doit donc pas reposer uniquement sur les coûts à court terme, mais sur les exigences à long terme en matière d’évolutivité, de sécurité, de maintenabilité et de conformité.
En règle générale : plus une entreprise compte de systèmes et de machines, plus un Unified Namespace lui apporte de bénéfices.
Construire un Unified Namespace – sans développement interne
AC4DC est la plateforme de gestion des données industrielles de FORCAM ENISCO. Elle connecte des parcs machines hétérogènes, contextualise les données et les met à disposition dans le Unified Namespace pour le MES, l’ERP et les applications d’IA – de la première usine à l’ensemble du réseau d’usines.
Conclusion
Le Unified Namespace résout un problème fondamental de la production numérique : des données collectées, mais impossibles à exploiter de manière uniforme. Ce qui compte, c’est moins le protocole que ce qui se trouve au-dessus : un modèle de données unifié et contextualisé, une architecture avec des couches informatiques séparées et une gestion centralisée qui évolue avec le parc machines. En intégrant ces briques dès le départ, on crée une IT de production transposable de l’usine pilote à l’ensemble du réseau d’usines et prête pour les applications d’IA.